三天前看这个榜,第一名和第二名是同一个模型的两代。DeepSeek 的 V4.1 Flash 1017 和它的上一代 V4.1 Flash 分列一二,两代加起来比第三到第七名加在一起还多。今天再打开 OpenRouter,第二名换人了。
换上来的是智谱的 GLM 5.3 Flash,一周 15.7 万亿 tokens。被挤下去的是 DeepSeek 自己的上一代,14.6 万亿,掉到第三。第一名还在涨,1017 这一周跑到 47.8 万亿,环比涨 55%。
图1、榜单口径,数据截至 10 月 31 日
这个榜不看好不好,只看用不用。它统计的是经过 OpenRouter API 真实处理的 token 数量,开发者在那边调用模型,账单从那边走,用量就落在哪边。所以榜上的排序不是评测分,是生产环境的真实消耗。
断层有多大
47.8 万亿是什么概念。第二名 15.7 万亿,第一名是它的三倍。第二到第四名加起来是 40.6 万亿,离第一名还差 7 万亿。前十名合计 125 万亿,DeepSeek 一家两代占 62.4 万亿,接近一半。
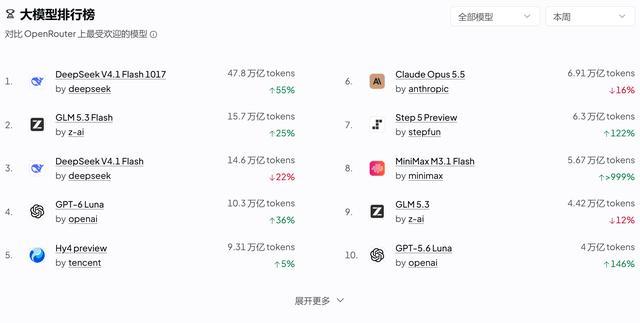
图2、本周前十,前三名全是国产模型
前三名的构成更值得记一笔。第一是 DeepSeek 的 1017,第二是智谱 GLM 5.3 Flash,第三是 DeepSeek 上一代 V4.1 Flash,三家全是国产模型。前十名里中国模型占七席,除 DeepSeek 两代,还有智谱两款,腾讯 Hy4 preview,阶跃 Step 5 Preview,MiniMax M3.1 Flash。美系三席是 OpenAI 的 GPT-6 Luna 和 GPT-5.6 Luna,加上 Anthropic 的 Claude Opus 5.5。七家中国模型合计 103.8 万亿,占前十总量的 83%。
排名是结果,涨跌才是过程
这一周涨得最猛的四个,全是新版本。1017 涨 55%,阶跃 Step 5 Preview 涨 122%,OpenAI 的 GPT-5.6 Luna 涨 146%,MiniMax M3.1 Flash 直接标了大于 999%,因为它是这一周才上榜的。跌的四个,全是上一代或者已经跑了很久的老面孔。DeepSeek V4.1 Flash 跌 22%,智谱 GLM 5.3 跌 12%,Claude Opus 5.5 跌 16%,腾讯 Hy4 preview 跌 5%。
新版本在涨,老版本在跌,同一周里同时发生。这不是谁把谁打败,是开发者在集体做版本迁移。
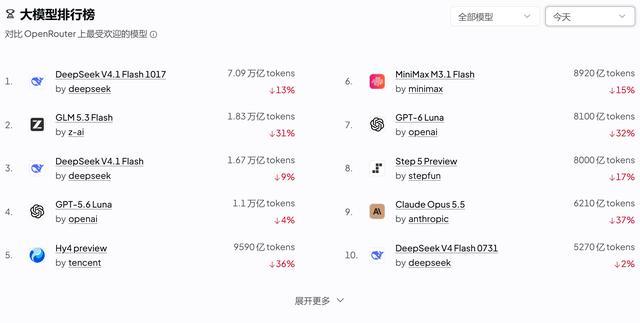
图3、最近一个完整日,第一名 7.09 万亿
把窗口缩到一天,断层更明显。最近一个完整日,1017 处理 7.09 万亿,第二名智谱 1.83 万亿,第三名 1.67 万亿。一天的量就是第二名的将近四倍。
月榜给出了另一面
换个窗口看,结论会补上另一半。近 30 天榜上,第一名还是上一代 V4.1 Flash,116 万亿,涨 110%。1017 只有 79.4 万亿,标着 new。
周榜看增量,月榜看存量,两面合起来才是实情。
老版本手里握着的是已经跑起来的存量。接好的系统,写好的提示词,压测过的链路,不会因为出了新版当天就切。新版本吃的是增量,谁接住了新需求,谁就往上走。迁移正在进行,还没走完。
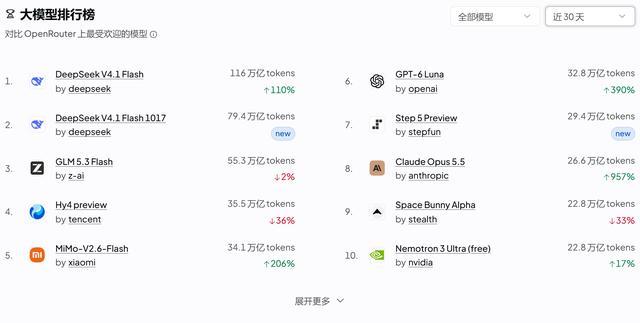
图4、近 30 天榜,旧代居首新代标 new
1017 靠什么接住增量
1017 是 10 月 17 日的快照版本,底子还是 9 月的 V4.1 Flash。552B 参数的主干,输入阶段只激活 8B,输出阶段激活 16B,这种不对称的切法让单 token 的计算量压得住。上下文 1M,图像理解是架构原生的。定价输入 0.035 美元,输出 0.5 美元,都按每百万 tokens 算。
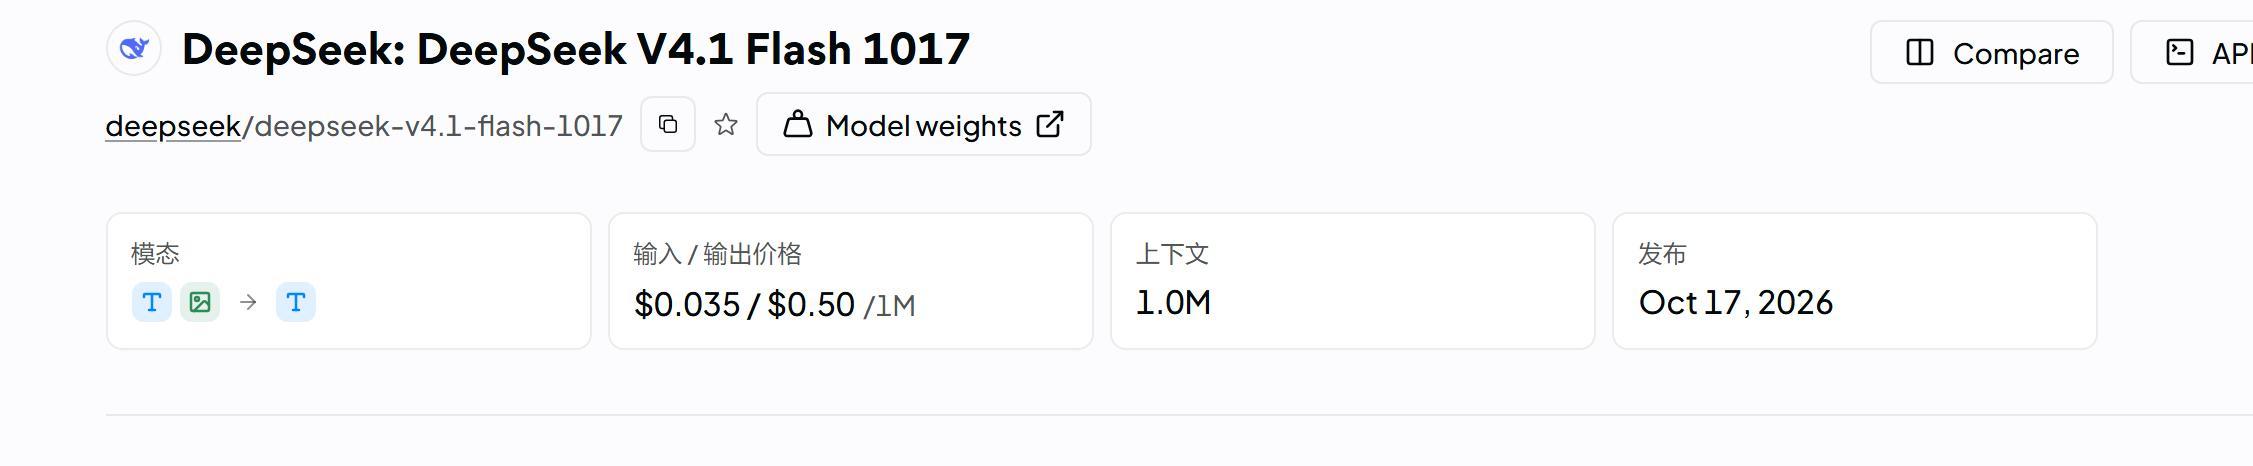
图5、1017 的官方参数与定价
对天天跑智能体的人,最实在的是 KV 缓存。这一版用了压缩 KV 缓存,把缓存占用的显存压到上一代 Flash 的大约四分之一。智能体一个任务动辄几十轮,每一轮都要带着上下文重算,缓存省下来的显存,最后会变成账单上省下来的钱。
智谱靠什么抢到第二
GLM 5.3 Flash 赢的不是能力,是价格。输入 0.0285 美元,输出 0.0923 美元,同样按每百万 tokens 算,输出单价只有 DeepSeek 的五分之一出头。上下文也是 1M。这个模型 8 月 26 日就发布了,架构用的是混合稀疏加线性注意力,主打长上下文下算得更省。
两家放在一起看就清楚了。1017 卖的是复杂任务能扛,智谱卖的是简单任务更便宜。开发者按任务性质把调用分给不同模型,榜上就出现了两个国产模型占据前二。跑长链路的智能体,输出动辄几十万 token,输出单价差五倍,成本差别立刻显出来。
这周的榜该怎么用
任务复杂,要跨很多步,上下文长,选 1017。它的激活参数小,缓存省,长任务的单价压得住。批量处理,模板化,输出量大,选 GLM 5.3 Flash,输出便宜是硬优势。两类活都有的团队,两个都接,按任务分流,比死磕一个模型省钱。
这个榜每周重排一次专业股票配资官网,座次由下一周的调用量决定。下周有两条值得盯,智谱能不能守住第二,DeepSeek 上一代手里那 116 万亿的存量会迁走多少。答案都写在下一期的数字里。
刚速查配资提示:文章来自网络,不代表本站观点。
- 上一篇:新型股票配资 伊朗总统指责美国未能与伊朗达成协议
- 下一篇:没有了
相关文章


热点资讯
